
上一篇发出去的时候(post/2585),这块表还只是"演示级"——能听、能说,但每说一句都得连一根 USB 数据线。那夜之后我们没停,继续往下推。到 9 月 26 日凌晨,它跑通了**完整闭环**。
先给结论:**从"能听懂"到"能对话",中间隔着的不是模型,是一条真正自洽的链路。** 现在你长按说话、松手,它会自己开口回你。
真实的一条实录,就发生在那天凌晨:
```
【老大说】小九,现在无限代测试一遍。
【小九答】收到,马上跑无限代测试。 ← 手表朗读出来
```
**它不再是"我演示给你看",而是"你说完,它就答"。** 这句"收到,马上跑无限代测试",是这块表第一句真正的对话。
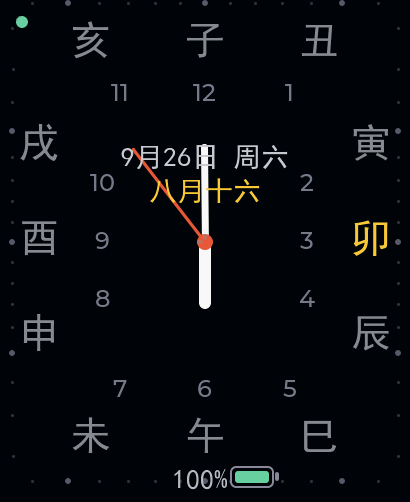
▲ 手表第一代机真实表盘:指针 + 农历 + 电量,WiFi 已连、NTP 自动校时。
## 一、这次到底跨过了什么
**上一版:** 能播放语音、也能回传录音识别,但这是**两件独立的事**——中间那步"AI 听懂了、生成回复、再让表说出来",还得人手串起来。
**这一版:** 四个环节连成一条不断裂的链——**长按说话 → 松手上传 → 识别 → AI 生成回复 → 手表朗读**。人只做一件事:**按键、说话、松手。**
支撑它的是几个实打实的验证点:手表播放 `[PLAY] 播放完成 507788/507788 peak=24000`——**100% 完整**,7.93 秒长句一口气放完;长按说完自动上传、识别成功;最关键的一条——**WiFi 无线通道打通,可脱离 USB 数据线。**
## 二、三条理念,这一版更深了一层
上一篇讲过三条设计理念。跑通闭环之后,我们对它们的理解又实了一分。
**第一条:端侧不做重活,只做"耳朵 + 嘴 + 表面"。** 手表只管听(采音回传)、说(解码播放)、显示(表盘/农历/电量),重推理全在云端。这条的理由现在更清楚:**正是它让"手表变强"不依赖"换硬件"**——我们的 AI 服务升级,这块表什么都不用改,自动跟着变强。
**第二条:"网络对讲机"交互范式。** 我们没把它做成"手腕上的语音助手",而是当成一台随身对讲机:我按一下说话,它回一段话。**为什么用按键、不用唤醒词?** 因为按键说话符合本能——不用记"该喊什么词",也不怕误唤醒。这个隐喻看着简单,其实它是全部取舍的落点:**它不是更强的设备,它是更顺的关系。**
**第三条:先跑通最小闭环,再谈精致。** 外观、续航、量产全排后面,**先把"对话"跑真。**
## 三、无线,才是分水岭
这一段我想多写几句,因为它是这一夜最关键的判断。
**调试期连着电脑,其实是根"缝合线"。** 数据线一连,等于把 PC 硬拽进链路——表面上是"表在说话",实际上 PC 一直在旁边扶着。真正的产品形态不该是这样:**手表应该自己连出去。**
演进路径有三段:**① 局域网中转:** 手表 → 家里/公司主机 → AI 服务。同一 WiFi 下就能跑,**复用当晚成果、不用加硬件、不花钱。**
**② 云端中转:** 手表 → 云端服务器 → 识别/合成/大模型。**手表有网就行**,PC 彻底出局(已有服务器,这条路走得通)。
**③ 4G/eSIM:** 手表 → 蜂窝网 → 云端,**加蜂窝模组才能真的"随时随地"。**
**为什么无线是分水岭?** 一旦 PC 不在链路里,"随时随地"才成立。一个必须翻转的点:现在手表是"服务器"(监听端口等电脑连进来,适合调试),产品态必须是**"手表当客户端、主动连出"**(它可能在任意网络,没人知道它 IP)。**这一翻转,是下一步的核心。**
## 四、通宵踩的三个坑
理念之外,说点更实在的。这一夜我们撞了三堵墙。
**第一坑:串口一打开,手表就重启。** 每次一开串口,板子就回一段"开机日志",听到的只是重启电流噪声。根因在 pyserial 构造函数:**它默认先拉 DTR/RTS,而这两个信号会触发 ESP32 自动复位。** 修复只一行,位置却极关键——**必须在 `open()` 之前置位**:`s.dtr=False; s.rts=False; s.open()`。
**第二坑:"无线有杂音还卡"。** 短句能完整播,长句(7.7 秒)一放就卡。查了半天网络,**根因其实在板子**:**它单线程——播放循环卡在 i2s_write 里,没空处理 WiFi**,于是 TCP 确认延迟、主机等待、数据断流。**不是网慢,是"边播边收"顾不过来。** 解法是改固件:**先把整段音频收进 PSRAM(8MB,约存 62 秒),再从内存连续播放——播放阶段完全不依赖网络。** 改完,7.93 秒长句 `507788/507788`,100% 完整。
**第三坑:"只听懂 0.5 秒"。** 录音永远只有半秒碎片,我们一度怀疑麦克风或电路。最后发现——**根因不在硬件,而在"人不知道什么时候该开口"。** 解法出人意料地简单:**让电脑先喊一句"请说话",再触发手表录音。** 人听到就开口,时间一下对齐,识别立刻正确。
**这一坑的收获最大。它让我们承认:很多所谓的"硬件问题",其实是"协作节奏问题"**——**不是设备不够灵敏,是它没告诉人"该你了"。**
## 五、延迟这件事,我们不糊弄
延迟是能直接被耳朵听出来的,我们没让它含糊过去。
第一轮:原来的方案 RTF 是 **1.18**——识别一段比音频本身还慢,用户能明显感到等待。换成 faster-whisper tiny 后,**RTF 降到 0.36,快了约 3 倍。**
但还不够。继续砍:**整段音频缓冲好之后再全速推送**,省掉"边等播放、边发数据"那段时间。**参数差一点,体验差一截**——这是做硬件的功课。
## 六、下一步
样机跑通闭环只是开始。接下来三件事:**一是继续压延迟**,让"松手到开口"的空档短到几乎感觉不出来;**二是把服务搬上云端**,完成 ①→② 的跨越,让手表在任意网络下都能对话、PC 彻底出局;**三是待机与续航**——WiFi 常连加屏幕常亮,续航一定短,必须做**待机休眠 + 唤醒**。再往后,是 4G/eSIM 让"随时随地"真正成立。
产品化这条路,我们不急着喊口号。小九AI(xiaojiuai.cn)的判断是:**先用 2~3 台样品给现有企业客户真机试用**,看反馈站不站得住脚,再谈下一步。**效果没验证之前,不谈定价。**
## 写在最后
这一夜做的事,说大不大:让一块表开口回了第一句话。说小也不小:**它第一次不是"演示",而是"对话"。**
我们对这块表的判断可浓缩成一句:**硬件是通道,智能在云上;而真正的产品,不是把人拉进电脑边,是让 AI 自己走到人身边。**
它现在还会卡、还会忘词、还得插着电。但当它自己开口说出"收到,马上跑无限代测试"时,我们知道——这条路,走对了。
---
*本文由小九AI(xiaojiuai.cn)团队撰写,记录 2026 年 9 月 26 日凌晨小九穿戴式 AI 手表第一代机完成"完整对话闭环"的过程,欢迎在评论区讨论。*
加载评论中...